 Isaque Victor cursos gratuitos
Em 17 de outubro eu escrevi aqui que a Meta ia passar a ter autorização, pelos novos Termos Comerciais, para ler o site da sua empresa com robôs, e que valia decidir o que fazer até 30 de outubro. A data passou, virou 20 de novembro, e agora a própria Meta diz que os termos novos não entram em vigor nessa data e estão pausados, sem data nova. Fui ler o aviso na página dela, a decisão da Justiça de São Paulo e o que Google e Microsoft anunciaram na mesma semana. O resultado é que a decisão de outubro não foi em vão, mas muda de forma.
O que aconteceu
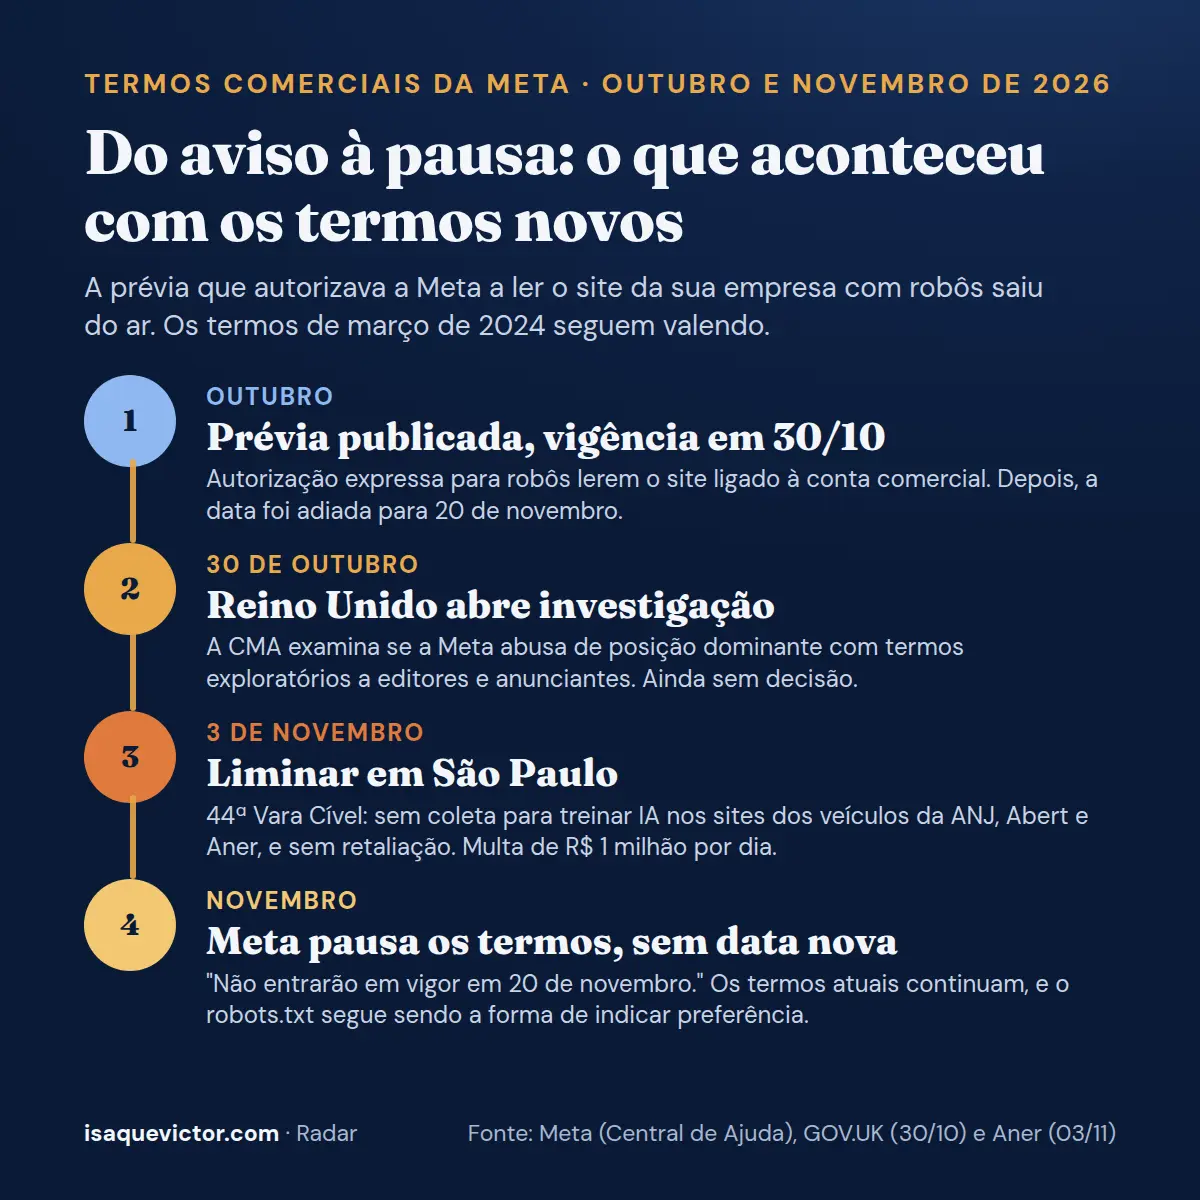
A Central de Ajuda da Meta para Empresas publicou uma nota com um título longo e direto: as atualizações dos Termos Comerciais, dos Termos do Catálogo de Produtos, dos Termos para Criação de Anúncios com Autoatendimento e dos Termos de IA Generativa para Criativo do Anúncio não entrarão em vigor em 20 de novembro de 2026 [1]. No texto, a empresa diz que as atualizações "estão pausadas", que segue "em diálogo com as partes interessadas" e que, enquanto isso, os termos existentes permanecem em vigor [1]. A página dos Termos Comerciais ganhou o mesmo aviso no topo: a prévia foi compartilhada, as atualizações estão suspensas e os termos atuais, com data de vigência de 6 de março de 2024, continuam valendo até novo aviso [2]. A página da prévia, que eu li em outubro, não mostra mais o texto novo.
A pausa veio depois de uma sequência de reações. Em 30 de outubro, a autoridade de concorrência do Reino Unido, a CMA, abriu investigação formal para examinar se a Meta abusa de posição dominante ao impor termos exploratórios a editores e anunciantes, e escreveu que os termos permitiriam acessar e usar conteúdo dos sites de veículos de imprensa para desenvolver os próprios produtos e serviços, inclusive os de IA; a própria CMA avisa que ainda não há decisão sobre descumprimento da lei [6]. Um tribunal da Noruega concedeu liminar suspendendo os termos, em caso apoiado por 180 empresas de mídia do país, segundo o 404 Media [3].
No Brasil, em 3 de novembro, o juiz Guilherme Madeira Dezem, da 44ª Vara Cível de São Paulo, concedeu liminar a pedido da ANJ, da Abert e da Aner [4][5]. A decisão proíbe a Meta de exigir, como condição para manter as contas, a autorização para coletar automaticamente o conteúdo dos sites dos veículos associados, suspende a parte dos termos sobre a coleta para treinar IA e proíbe o uso de robôs e rastreadores para esse fim nos sites dessas empresas [5]. A Meta também fica obrigada a manter as contas, páginas e ferramentas dos veículos em pleno funcionamento no Facebook, no Instagram, no WhatsApp e no Threads, sem retaliação a quem recusar os termos, com multa diária de R$ 1 milhão e teto de R$ 100 milhões [4][5]. A liminar vale para os associados das três entidades [4]. À Poder360, a Meta disse que não vai se pronunciar sobre a decisão [5].
Por que isso importa
A pausa não é o fim do assunto. A Meta escreve que segue conversando e que vai compartilhar novas informações assim que possível [1]. Ou seja, uma versão nova dos termos pode voltar, com outra redação e outra data. Quem decidiu em outubro o que no site é vitrine e o que é conteúdo próprio não perdeu tempo: essa separação continua sendo a base de qualquer decisão sobre robôs de IA, venham eles da Meta ou de outra empresa.
O ponto mais útil da nota da Meta está no último parágrafo. A empresa lembra que as práticas de rastreamento dela "permanecem inalteradas" e que os donos de conteúdo "podem continuar indicando suas preferências por meio do arquivo robots.txt", conforme a documentação para desenvolvedores [1]. Essa documentação segue descrevendo o Meta-ExternalAgent como o robô que rastreia a web para treinar modelos de IA ou melhorar produtos, com as regras de robots.txt para barrá-lo [7]. Em outubro eu escrevi que não estava claro se o bloqueio no robots.txt prevalecia sobre a autorização dada no contrato. Com o contrato novo fora do ar, o arquivo volta a ser a ferramenta que decide, e a Meta a reconhece por escrito.
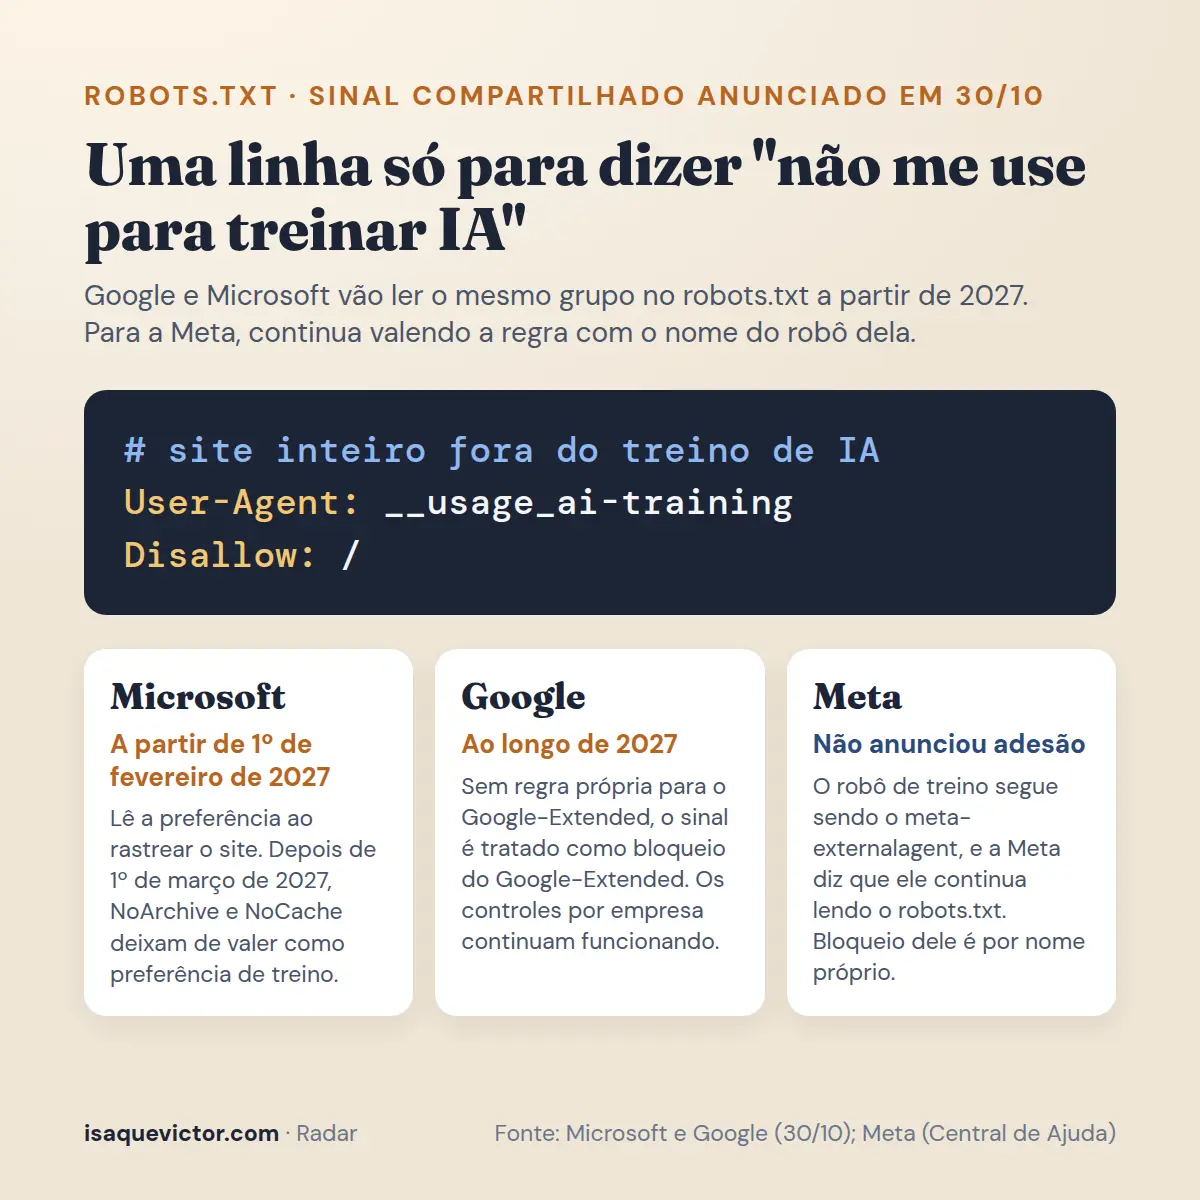
Na mesma semana da investigação no Reino Unido, em 30 de outubro, Google e Microsoft anunciaram um passo que facilita a vida de quem cuida de site pequeno: um sinal compartilhado no robots.txt para dizer, de uma vez, que o site não quer servir de material de treino para IA [8][9]. A Microsoft mostra a sintaxe: um grupo `User-Agent: __usage_ai-training` seguido de `Disallow: /` para o site inteiro, ou de um caminho para bloquear só uma parte [9]. Ela passa a honrar essa preferência a partir de 1º de fevereiro de 2027 e avisa que, depois de 1º de março de 2027, as marcações NoArchive e NoCache deixam de valer como preferência de treino [9]. O Google diz que pretende suportar o controle em 2027, junto com outros provedores de IA, e que um site que usar o sinal sem citar o Google-Extended será tratado como se tivesse bloqueado o Google-Extended; os controles por empresa continuam funcionando ao lado do sinal conjunto [8]. A Meta não aparece entre os que anunciaram adesão, então, para o robô dela, a regra continua sendo a do nome próprio, meta-externalagent [7].
Para fechar
Em outubro eu disse que a decisão não era sair das redes, e sim saber o que o seu site entrega a quem o lê. Isso continua. A diferença é que agora existe uma pausa para fazer isso sem pressa, e uma linha única de robots.txt a caminho para dizer a mesma coisa a várias empresas de IA de uma vez. Se você quer conferir como está o arquivo da sua empresa hoje, essa continua sendo uma conversa que a IV Help faz com gosto.
Na prática
O que isso muda para o seu negócio
- Faça: se você bloqueou o meta-externalagent no robots.txt em outubro, mantenha: a Meta diz que o robô continua seguindo o arquivo [1][7]. Se ainda não fez nada, a decisão de separar vitrine de conteúdo próprio continua valendo, e agora com mais calma. Peça a quem cuida do site para anotar, no mesmo arquivo, o grupo `__usage_ai-training` com a sua preferência: ele começa a ser lido pela Microsoft em fevereiro de 2027 e pelo Google ao longo de 2027 [8][9].
- Evite: achar que a liminar de São Paulo protege a sua empresa. Ela vale para os veículos associados à ANJ, à Abert e à Aner [4]. Para o site de uma loja, de uma clínica ou de uma escola, o que vale é o robots.txt e, quando voltarem, os termos que você aceitar ao continuar usando as ferramentas comerciais da Meta.
- Observe: a nota da Meta na Central de Ajuda [1]. É ali que deve aparecer a próxima versão dos termos e a nova data. E acompanhe o que a CMA concluir no Reino Unido [6], porque o resultado tende a influenciar a redação que chega ao resto do mundo.
Fontes citadas
- As atualizações dos Termos Comerciais da Meta, dos Termos do Catálogo de Produtos, dos Termos para Criação de Anúncios com Autoatendimento e dos Termos de IA Generativa para Criativo do Anúncio não entrarão em vigor em 20 de novembro de 2026Meta, Central de Ajuda para Empresas · 07/11/2026
- Termos Comerciais da Meta (aviso de suspensão no topo da página)Meta · 07/11/2026
- Everyone Everywhere Hated Meta's New AI Training Terms. Now, They're On Pause404 Media · 05/11/2026
- Justiça proíbe Meta de usar conteúdo jornalístico sem autorização após ação de ANJ, ABERT e ANERAner · 03/11/2026
- Justiça de SP proíbe Meta de usar conteúdo jornalístico para treinar IAPoder360 · 03/11/2026
- CMA opens investigation into Meta's commercial termsGOV.UK, Competition and Markets Authority · 30/10/2026
- Meta Web CrawlersMeta for Developers · 07/11/2026
- Supporting a shared AI training control for websitesGoogle Search Central Blog · 30/10/2026
- Your content, your choice: clearer preferences for training and groundingMicrosoft Bing Blog · 30/10/2026
Comentários
Ainda não há comentários. Comece a conversa.